

Überprüfen Sie Ihre Crawler-Berechtigungen und kontrollieren Sie das KI-Datenscraping – kostenlos.
Im Zeitalter von Generative KI, Ihre robots.txt-Datei ist das wichtigste Sicherheitsdokument auf Ihrem Server. Sie ist das Tor, das Googlebot "Willkommen" sagt und GPTBot (OpenAI) oder CCBot (Common Crawl) mitteilt, ob sie Ihre proprietären Inhalte aufnehmen dürfen, um ihre Modelle zu trainieren.
Der MultiLipi Robots.txt-Validator ist ein kostenloses technisches Dienstprogramm zur Überprüfung Ihrer Berechtigungsregeln. Es stellt sicher, dass Sie nicht versehentlich SEO-Traffic blockieren, und überprüft gleichzeitig Ihre Haltung gegenüber KI-Scraping-Agenten.
Die "Sicherheitsschleife" – Essentiell
SEO-Sichtbarkeit vs. KI-Datenschutz.
Ein einziger Syntaxfehler in dieser Datei kann Ihre gesamte Website von Google deindexieren. Umgekehrt kann eine fehlende Regel KI-Unternehmen erlauben, Ihr gesamtes Blog-Archiv ohne Vergütung zu scrapen.
Das SEO-Risiko
Das Blockieren von Googlebot oder Bingbot zerstört Ihren Traffic.
Das KI-Risiko
Wenn Sie GPTBot oder ClaudeBot zulassen, werden Ihre Inhalte zu Trainingsdaten.
Das Gleichgewicht
Unser Tool validiert, dass Ihre "Allow"- und "Disallow"-Direktiven syntaktisch korrekt sind und auf die spezifischen Agents abzielen, die Sie verwalten möchten.
Das Audit-Protokoll
So validieren Sie Ihren Gatekeeper.
Gehen Sie nicht davon aus, dass Ihre Berechtigungen korrekt sind. Überprüfen Sie sie anhand der Live-Crawler-Standards.
Greifen Sie auf das kostenlose Tool zu
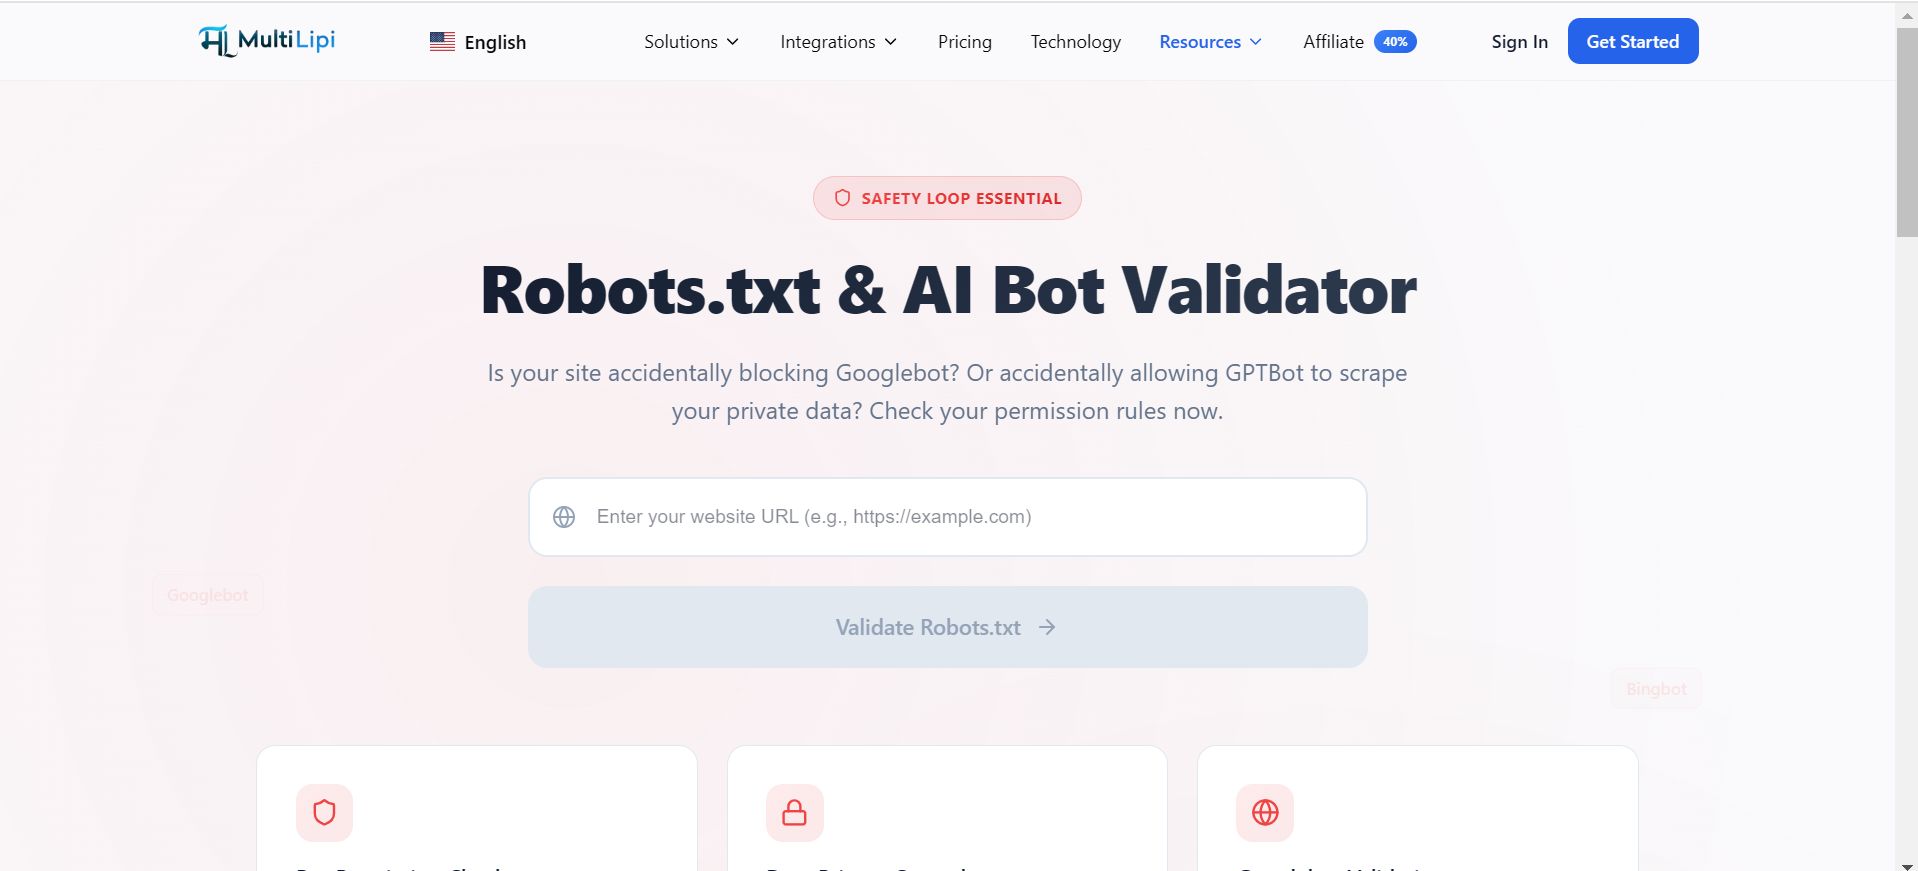
Navigieren Sie zum Robots.txt-Validator.
Eingabepunkt
Geben Sie Ihre Root-Domain ein (z. B. https://example.com).
Scan ausführen
Klicken Sie auf die Schaltfläche "Robots.txt validieren".
Logik überprüfen
Untersuchen Sie die Syntaxprüfung, die bot-spezifische Analyse und die Erreichbarkeit.
Logikprüfung:
Syntaxprüfung: Kennzeichnet ungültige Wildcards oder Pfadfehler
Bot-spezifische Analyse: Überprüft speziell die Berechtigungen für wichtige Agents wie Googlebot, GPTBot, Bingbot und CCBot
Erreichbarkeit: Bestätigt, dass die Datei zugänglich ist und einen 200 OK-Statuscode zurückgibt
Kontrolle des Wissensgraphen
Entscheiden Sie, wer von Ihnen lernt.
Wenn Sie ein Premium-Publisher oder eine SaaS-Plattform sind, möchten Sie möglicherweise generische KI-Scraper blockieren und gleichzeitig Suchmaschinen aktiv halten.
Szenario
Sie möchten in den Google Suchergebnissen erscheinen, aber nicht, dass ChatGPT Ihre Paywall-Artikel kostenlos wiedergibt.
Lösung
Verwenden Sie den Validator, um sicherzustellen, dass Ihre User-agent: GPTBot Disallow: / Regel korrekt implementiert und von Ihren User-agent: * Regeln abweicht.
Mehrsprachige Sitemaps
Verbindung Ihrer Infrastruktur.
Ihre robots.txt ist auch der Kartenraum für Ihre Crawler. Sie sollte explizit auf Ihre XML-Sitemap verweisen.
Die Prüfung
Unser Tool überprüft, ob eine Sitemap: https://yoursite.com/sitemap.xml Direktive vorhanden ist.
Die globale Auswirkung
Dies ist entscheidend für die Entdeckung Ihrer lokalisierten Unterverzeichnisse (z. B. /fr/, /es/). Wenn der Crawler die Sitemap nicht über robots.txt finden kann, bleiben Ihre tiefgreifenden übersetzten Seiten möglicherweise unentdeckt.